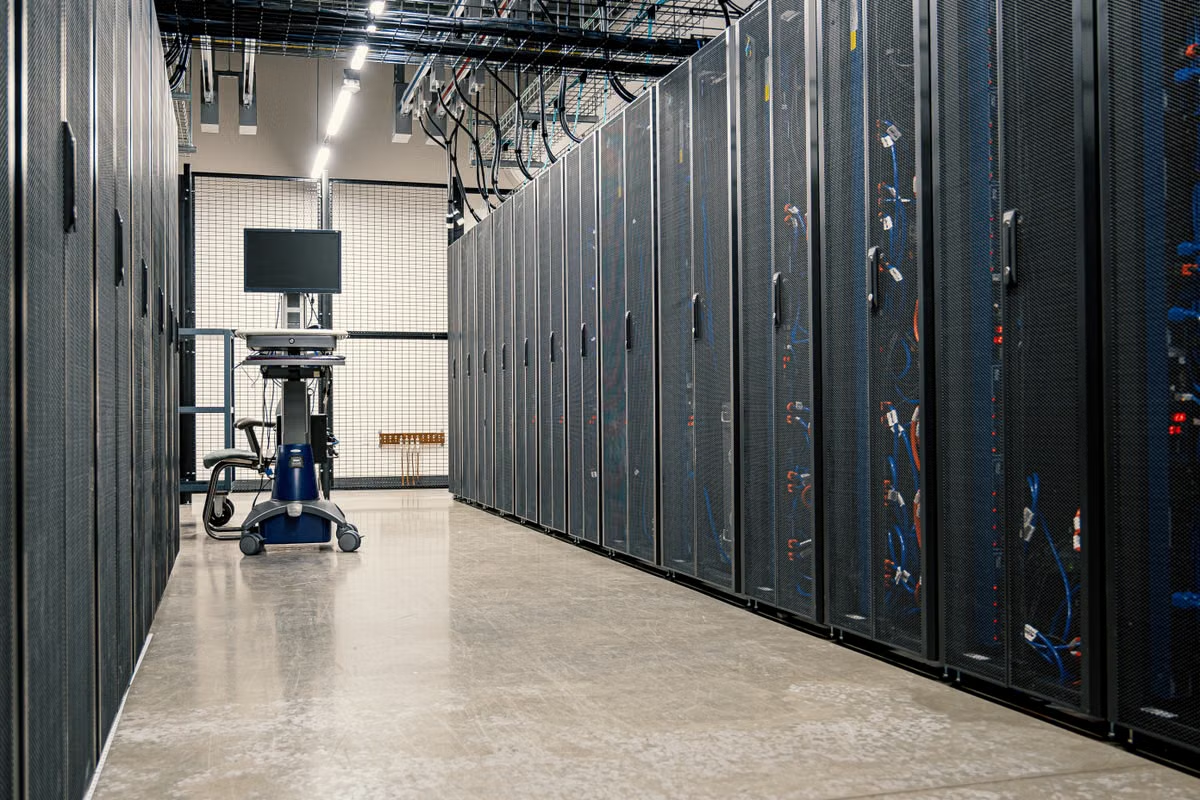
Un chiffre pour cadrer le problème
L’Agence internationale de l’énergie estime que les centres de données ont consommé environ 415 TWh d’électricité en 2024, soit près de 1,5 % de la consommation mondiale d’électricité (analyse de l’AIE sur la demande énergétique liée à l’IA). Ce chiffre ne décrit pas le coût d’un centre particulier, mais il rappelle que la structure des coûts d’un centre de données d’IA dépasse largement l’achat de GPU. Vous devez aussi prendre en compte l’alimentation électrique, le refroidissement, la capacité des locaux, le réseau et l’exploitation. Le coût d’une inférence dépend ensuite de l’utilisation réelle des équipements, du modèle et de la chaîne de service : ne transposez pas directement le montant d’un site à votre application.
Cet article s’adresse aux développeurs qui cherchent à comprendre le prix de l’inférence en nuage, aux étudiants qui étudient les liens entre calcul, énergie et refroidissement, ainsi qu’aux responsables techniques qui préparent un budget produit. Il vous aide à distinguer investissement initial, dépenses récurrentes et coût d’un service rendu.
Séparer l’investissement du coût par requête
Un centre de données engage plusieurs catégories de dépenses, qui ne correspondent ni aux mêmes périodes ni aux mêmes unités de mesure.
- L’investissement initial couvre les accélérateurs, les serveurs, le réseau, le stockage, l’alimentation électrique, le refroidissement et les aménagements nécessaires à l’installation.
- Les dépenses d’exploitation comprennent l’électricité, la maintenance, les remplacements, les équipes, les contrats de service et les équipements maintenus en réserve.
- Le coût d’inférence rapporte les ressources employées pour servir un modèle à une unité choisie : requête, lot, durée de calcul ou quantité de jetons traités. Selon la méthode retenue, il peut inclure ou exclure le stockage, le réseau et les fonctions applicatives.
Ces postes ne se divisent pas automatiquement par le nombre de requêtes. Pour répartir les coûts d’infrastructure sur les services, vous devez préciser la période considérée, le niveau d’utilisation des accélérateurs et le traitement des capacités inutilisées ou réservées à la continuité de service. Deux équipes peuvent donc annoncer des coûts unitaires différents pour des équipements comparables, simplement parce qu’elles n’utilisent pas la même méthode de calcul.
Pourquoi le coût total d’un centre de données diffère-t-il du coût d’une inférence ? Le premier additionne des achats et des frais associés à un site ou à une capacité de calcul ; le second impute une partie de ces dépenses à un service et à un volume d’usage. Avant de comparer une offre en nuage à un déploiement interne, vérifiez que les estimations couvrent les mêmes postes et la même période.
Première étape : évaluer les GPU et leur environnement
Le coût d’achat d’un GPU n’est que le début de la dépense matérielle. Les accélérateurs doivent être intégrés à des serveurs compatibles, alimentés et refroidis. Il faut aussi prévoir les connexions entre machines, le stockage des données et les opérations d’installation, de validation et de maintenance. Une estimation limitée au prix d’une carte ne décrit donc ni une capacité prête à servir un modèle ni le coût complet de son maintien en production.
La documentation de configuration de NVIDIA indique, pour un modèle précis de GPU H100 en configuration PCIe, une puissance de 350 W (guide de configuration des serveurs NVIDIA). Cette valeur concerne le matériel et la configuration documentés, pas un serveur complet ni tous les centres de données. Ne la confondez pas avec une mesure à la prise : processeurs, mémoire, ventilateurs, réseau, pertes électriques et refroidissement ajoutent d’autres postes.
Dans un projet audio ou vidéo, le GPU peut servir à l’inférence, à la préparation des données et à des traitements annexes. Si ces tâches partagent les mêmes machines, le coût affecté à la seule inférence dépend de la règle de répartition choisie. Une capacité dédiée peut simplifier cette attribution, mais vous payez alors aussi les périodes où la machine attend des requêtes. Votre inventaire doit distinguer les accélérateurs, les serveurs complets, les équipements réseau et les services qui exécutent effectivement le modèle.
Que faut-il comparer dans le coût d’achat des GPU ? Comparez l’équipement complet nécessaire au service, et non la seule référence du GPU : compatibilité serveur, mémoire, réseau, stockage, installation et durée d’exploitation prévue. Si un devis ne précise pas ces hypothèses, demandez-les avant de le rapprocher d’une offre facturée par requête.
Deuxième étape : relier le calcul à l’électricité
Les GPU consomment de l’énergie pendant le calcul, mais le compteur du site couvre généralement davantage que les seuls accélérateurs. Il peut inclure les serveurs, les équipements réseau, la conversion et la distribution électrique, ainsi que le refroidissement. Toute comparaison doit donc préciser si la mesure porte sur une carte, un serveur, une salle ou le centre de données dans son ensemble.
L’AIE projette que la consommation électrique mondiale des centres de données pourrait atteindre environ 945 TWh en 2030, selon son scénario central. Cette projection n’est ni une mesure de chaque installation ni une estimation de la part imputable à l’IA dans votre projet : elle décrit une évolution agrégée et doit être lue dans le périmètre défini par l’AIE (données et projections sur l’énergie et l’IA). Pour établir votre budget, utilisez les relevés correspondant à la période étudiée, le tarif d’électricité applicable et une définition explicite des équipements inclus.
Le poste énergétique varie selon la charge et le profil de fonctionnement du site. Une machine qui traite des requêtes en continu n’a pas le même profil qu’une capacité réservée aux pointes ; dans ce second cas, une partie de la puissance disponible peut rester peu utilisée tout en étant maintenue prête. La facturation peut également dépendre de la puissance souscrite, des périodes tarifaires ou de frais de raccordement. Le nombre de GPU ne suffit donc pas à calculer la facture d’électricité.
Pourquoi le GPU n’explique-t-il pas à lui seul les besoins électriques ? Parce que l’électricité alimente aussi les serveurs et les installations qui rendent leur exploitation possible. Le rapport du département américain de l’Énergie sur la consommation des centres de données aide à définir le périmètre énergétique à examiner (rapport sur l’usage énergétique des centres de données aux États-Unis). Une moyenne nationale ne doit toutefois pas être présentée comme la consommation de votre salle ou de votre service.
Troisième étape : intégrer le refroidissement et les limites du bâtiment
Le refroidissement répond à une contrainte physique : les équipements convertissent une partie de l’énergie consommée en chaleur qu’il faut évacuer. La puissance qu’une salle peut accepter dépend donc du refroidissement disponible, de l’alimentation et de la configuration des baies. Si l’un de ces éléments devient un goulot d’étranglement, la surface disponible ne se transforme pas nécessairement en capacité de calcul exploitable.
Les recommandations de conception de NVIDIA montrent que l’installation d’une plateforme accélérée doit être étudiée comme un système, avec la distribution électrique, la circulation d’air et les contraintes d’intégration (guide de conception des centres de données DGX H100). Ce guide porte sur une conception déterminée : il ne permet pas d’attribuer ses exigences ou ses choix de refroidissement à toutes les salles informatiques.
Pour examiner les coûts liés au refroidissement et à l’espace, demandez comment l’exploitant les calcule et quelle capacité reste disponible lorsque les équipements fonctionnent dans la configuration prévue. Une densité de calcul supérieure peut réduire la surface nécessaire pour une capacité donnée, mais elle peut aussi imposer des adaptations électriques et thermiques. Le compromis dépend du site ; sans mesures ou plans correspondant à l’installation, annoncer une économie universelle serait trompeur.
À retenir : la puissance nominale d’un GPU n’est pas une mesure de la consommation du centre. Pour comparer deux configurations, alignez le périmètre du relevé, la charge exécutée et les équipements auxiliaires inclus.
Quatrième étape : compter les locaux, le réseau et l’exploitation
L’infrastructure ne se limite pas à la salle où se trouvent les serveurs. Elle comprend les locaux, les raccordements, les systèmes de surveillance, les dispositifs de protection et les opérations nécessaires au maintien du service. Ces dépenses peuvent apparaître directement dans un budget interne ou être intégrées à un tarif en nuage sans figurer sous une ligne distincte.
Le réseau remplit plusieurs fonctions : transférer les données vers les accélérateurs, relier les machines entre elles et envoyer les résultats aux applications. Pour un service qui échange de nombreux fichiers, images, séquences vidéo ou données d’entraînement, les frais de transfert et les limites de débit peuvent peser dans la décision autant que le prix du calcul. Les principes officiels de tarification des services en nuage distinguent plusieurs catégories plutôt qu’un montant unique représentant « l’infrastructure » (principes de tarification des services en nuage). Les recommandations d’architecture sur les transferts de données invitent également à traiter ces flux comme un poste de coût à planifier (guide de planification des coûts de transfert de données).
L’exploitation ajoute des dépenses moins visibles dans une estimation sommaire : interventions après une panne, remplacement de composants, mises à jour logicielles, suivi des performances et maintien d’équipements redondants. La redondance réduit le risque d’interruption, mais une ressource de secours ne produit pas nécessairement autant de requêtes qu’une ressource constamment chargée. Intégrez ce choix à la répartition des coûts au lieu de traiter les machines de réserve comme gratuites.
Cinquième étape : faire de l’utilisation une variable
Le taux d’utilisation joue un rôle important dans le coût imputé à une inférence, mais il ne faut pas lui attribuer une valeur universelle sans mesure vérifiable. Une plateforme très sollicitée peut répartir ses coûts fixes sur davantage de requêtes ; une capacité dimensionnée pour les pointes peut, à l’inverse, rester partiellement inactive. Ces deux choix peuvent répondre à des exigences de latence ou de disponibilité, tout en conduisant à des coûts unitaires différents.
Pour analyser votre cas, observez la charge par période, le temps d’occupation effectif des accélérateurs, les attentes en file, les tâches partageant la capacité et les périodes réservées à la reprise après incident. Distinguez aussi le débit théorique de la production réellement facturable : un modèle qui traite vite une requête ne garantit pas un coût unitaire faible si la préparation des données, l’attente ou les transferts mobilisent d’autres ressources.
Prenons une équipe qui génère des descriptions d’images pour une application de conception. Une campagne de création peut concentrer la demande sur une période, alors que l’activité est plus faible le reste du temps. Pour mesurer le coût pertinent, l’équipe doit rapporter l’ensemble des ressources utilisées aux résultats effectivement exploitables, en précisant si elle inclut les essais, les requêtes échouées, le prétraitement des images et le stockage. Ce calcul est plus instructif qu’un prix par heure de GPU présenté sans contexte.
Comment l’investissement dans le centre influence-t-il le coût d’une inférence ? Une partie des investissements et des dépenses d’exploitation est imputée à la capacité qui sert le modèle. Cette part dépend de la période d’amortissement retenue, de l’utilisation, des réserves de disponibilité et du volume servi ; elle ne peut pas être déduite du seul prix d’achat d’un accélérateur.
Utiliser un outil de décision avant de choisir une capacité
Cochez la condition qui correspond à votre besoin, puis suivez la branche indiquée. Si plusieurs situations s’appliquent, partez de la contrainte la plus forte : disponibilité, volume ou délai de réponse.
- [ ] Vous validez un prototype ou une chaîne applicative, sans besoin d’un débit d’inférence continu. Commencez par estimer les requêtes et les ressources réellement consommées ; comparez ensuite une facturation à l’usage en vérifiant les frais de transfert et de stockage.
- [ ] Vous envisagez de réserver ou d’exploiter une capacité GPU. Exigez une estimation couvrant serveurs, alimentation, refroidissement, redondance et utilisation prévue. Si ces informations manquent, revenez à une mesure de charge avant de conclure à un avantage économique.
- [ ] Votre activité connaît de fortes variations. Vérifiez si la capacité peut suivre la demande et si les périodes creuses restent facturées. Si le service doit rester disponible en permanence, incluez le coût de cette disponibilité dans le budget.
- [ ] La facture augmente alors que le volume d’inférence reste stable. Examinez d’abord le réseau, le stockage, le prétraitement et les ressources actives entre les requêtes ; n’attribuez pas automatiquement la hausse au modèle.
- [ ] Vous comparez deux offres dont les unités diffèrent. Ramenez-les à un même périmètre : période, volume traité, qualité de service et postes inclus. Si l’un des devis omet ces éléments, ne le comparez pas directement à un prix par requête.
Cette vérification distingue le coût d’infrastructure du coût de service. Elle vous évite notamment de traiter le montant global d’un centre comme s’il correspondait au prix d’une requête, ou de déduire le coût interne d’un fournisseur à partir d’une facture qui n’en révèle qu’une partie.
Lire un devis d’inférence sans confondre les postes
Une facture peut juxtaposer des frais exprimés dans des unités différentes. Séparez le temps ou la capacité de calcul, les appels au modèle, le traitement des requêtes, le stockage et le transfert de données. Vérifiez ensuite si le tarif couvre les données d’entrée et de sortie, les opérations annexes et les ressources maintenues actives entre les requêtes. Les règles tarifaires officielles décrivent des catégories de services distinctes ; pour comparer deux offres, précisez donc les lignes comprises dans le prix annoncé.
Le coût d’inférence des modèles dépend de l’infrastructure, mais aussi de la chaîne logicielle, du partage de capacité et des règles de facturation. Sans informations détaillées, vous pouvez étudier les postes visibles et vos propres mesures ; vous ne pouvez pas reconstruire précisément le coût interne d’un fournisseur à partir de la seule facture.
Avant d’augmenter une capacité, définissez ce que vous cherchez à optimiser : coût par requête, délai de réponse, volume traité ou disponibilité. Mesurez toute la chaîne, de l’arrivée des données au résultat consommable par l’application, puis séparez le calcul du réseau, du stockage et de l’exploitation. Vous verrez ainsi si la difficulté vient du modèle, d’une charge mal répartie ou de ressources annexes toujours actives.
Pour un service d’inférence exigeant un débit élevé et régulier, une infrastructure GPU adaptée peut être nécessaire ; la comparer à une machine de développement généraliste n’aurait pas de sens. En revanche, si vous voulez valider une interface, réaliser des essais locaux ou tester un flux audio ou vidéo sans héberger une charge d’inférence massive, comparez le coût d’une infrastructure distante à celui d’un environnement Mac temporaire. Un Mac ne remplace pas une infrastructure GPU destinée à entraîner ou servir un grand modèle, mais il peut éviter de mobiliser cette dernière pour des tâches de développement qui n’en ont pas besoin.
L’environnement que vous utilisez actuellement peut entraîner des frais de capacité inutilisée, demander du temps de configuration et rendre difficile l’attribution des frais de réseau ou de stockage au modèle lui-même. Pour des essais côté application, la location d’un Mac auprès de Macstripe peut fournir un environnement dédié, sans prétendre réduire le coût d’inférence d’un service GPU en production. Pour vérifier si ce type d’environnement correspond à votre besoin, consultez la présentation de Macstripe et les informations pratiques disponibles dans son centre d’aide avant de décider.
